Книга «Буквы XX века» · глава о прописях · июль — август 2025
Скрытый лимит ChatGPT, о котором он сам не говорит
База из 18 изданий — букварей, прописей, методичек 1900–1990 годов. Обычный текстовый PDF весит сотни килобайт; эти, из-за сотен сканов, уходили за 10 мегабайт, а один — за 150. Ниже — два моих поста того времени: как это выглядело изнутри и что в итоге оказалось причиной.
Коротко
Что оказалось причиной
Симптом
После восьми-десяти PDF любая новая загрузка молча срывалась — в любом проекте, даже файл меньше мегабайта. Без сообщения об ошибке.
Причина
Недокументированный лимит: суммарный объём файлов в проекте — не больше 80 МБ, и порог действует на весь аккаунт, а не на один проект. ChatGPT назвал цифру только на прямой вопрос.
Обход
Разделить базу на группы (книги отдельно, тетради отдельно), нарезать издания на части, ужать до десяти файлов по десять мегабайт. После этого база из 18 изданий заработала.
Документы
Два поста того времени
Мой разбор бага и рассказ автора о тех же двух неделях — как это выглядело с его стороны.
18.08.2025 · «Баг ChatGPT, о котором никто не рассказывает» — мой пост в Telegram
Баг ChatGPT, о котором никто не рассказывает Даже сам ChatGPT признаётся только, если долго и методично его дрючить.
Помните, я обещала поделиться тем, что выяснила, когда искала материалы для книги о буквах Юрия Гордона?
Все, кто работает с проектами, знают: официально по подписке Plus можно загружать до 20 файлов в проект, одновременно можно загружать максимум 10 файлов. Есть ограничения по весу и формату.
На практике всё куда жёстче. Оказывается, есть системный баг, который нигде не прописан и даже сам ChatGPT в нём не признаётся. Он выдал правду только тогда, когда я схватила его за яйца. Я была в бешенстве. Потому что у меня ушла целая неделя работы, чтобы вскрыть этот косяк.
Что произошло После загрузки 8–10 PDF-файлов (независимо от их размера) ChatGPT начал отклонять любые новые загрузки.
Даже если:
- это другой проект,
- файл весит меньше 1 МБ.
То есть выглядит как сбой, а по факту — скрытый лимит, который работает не на проект, а на весь аккаунт/сессию.
Суть бага
- Сейчас ChatGPT не принимает PDF тяжелее 10 МБ (раньше можно было больше).
- Лимит распространяется на аккаунт в целом, а не на конкретный проект.
- Если превысить порог (8–10 файлов), загрузка блокируется везде: и в личных чатах, и в других проектах, и в базе памяти.
Я пыталась обмануть систему — загружала PDF напрямую в чат проекта, просила работать с ними без добавления в память. Но всё бесполезно: лимит на загрузку PDF-файлов действует на весь аккаунт, а не только на проект или чат.
Самое коварное Ошибка не проявляется явно.
Ты не получаешь сообщение о лимите. Загрузка просто «тихо» срывается — будто ничего и не было.
Этот системный баг нигде не описан, и даже сам ChatGPT упорно отмораживается, пока не прижмёшь его к стенке.
У меня ушла целая неделя, чтобы докопаться до истины.
14.07.2025 · «Как мы учили двойника кушать пдфы» — рассказ Юрия Гордона, репост в моём канале
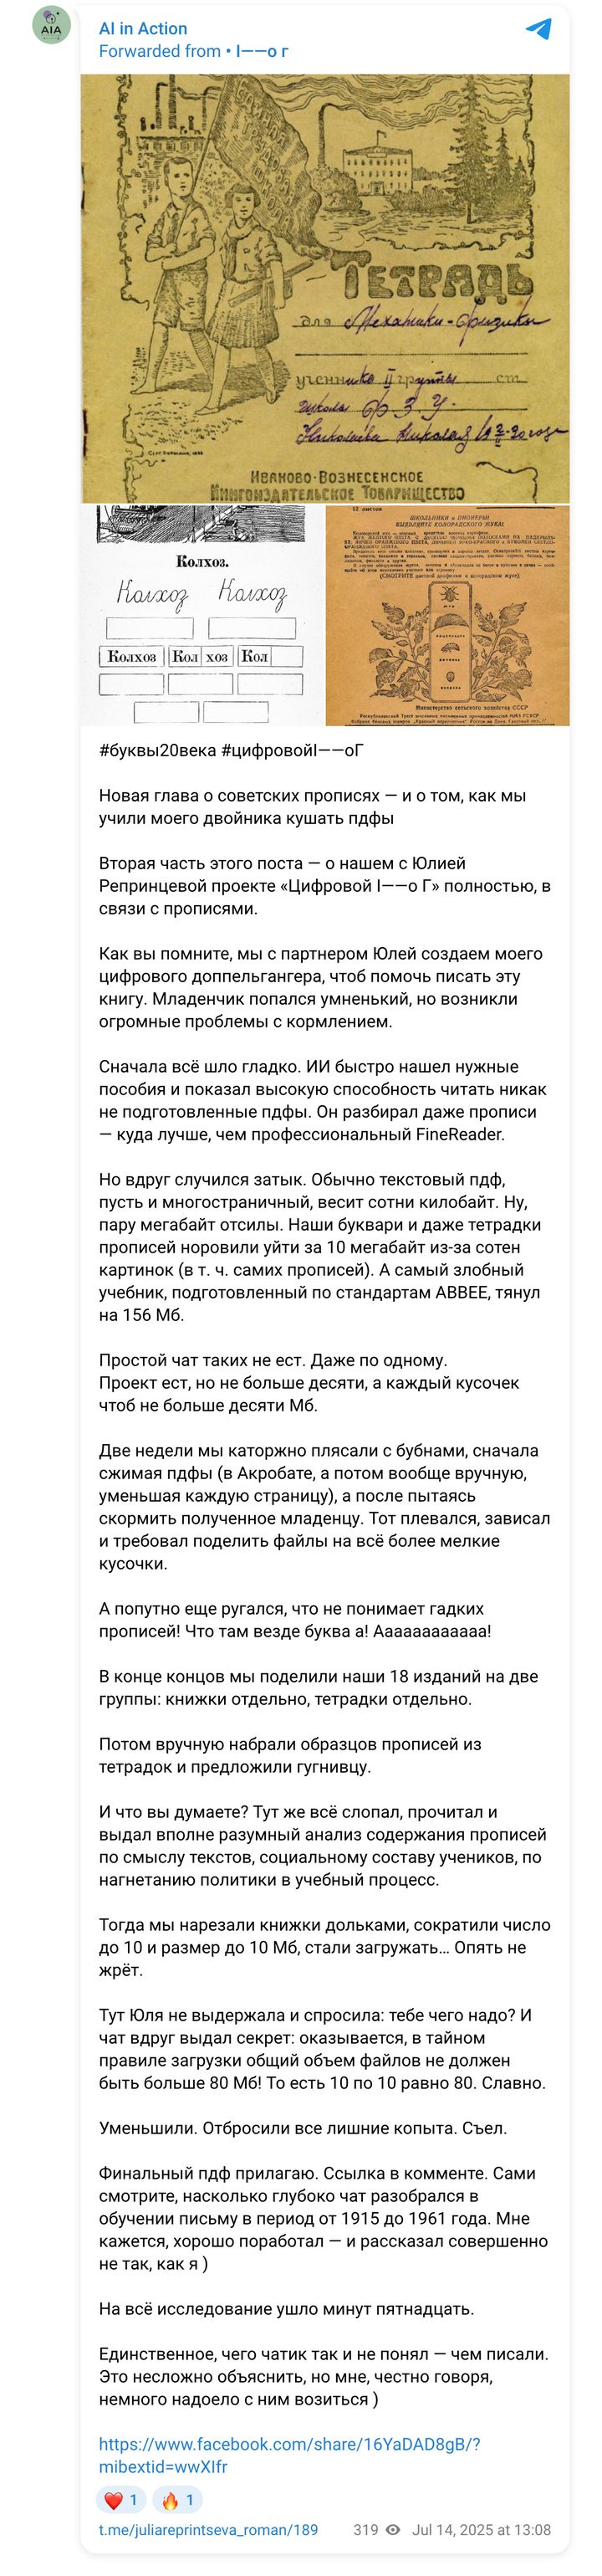
Новая глава о советских прописях — и о том, как мы учили моего двойника кушать пдфы
Вторая часть этого поста — о нашем с Юлией Репринцевой проекте «Цифровой I——о Г» полностью, в связи с прописями.
Как вы помните, мы с партнёром Юлей создаем моего цифрового доппельгангера, чтоб помочь писать эту книгу. Младенчик попался умненький, но возникли огромные проблемы с кормлением.
Сначала всё шло гладко. ИИ быстро нашел нужные пособия и показал высокую способность читать никак не подготовленные пдфы. Он разбирал даже прописи — куда лучше, чем профессиональный FineReader.
Но вдруг случился затык. Обычно текстовый пдф, пусть и многостраничный, весит сотни килобайт. Ну, пару мегабайт отсилы. Наши буквари и даже тетрадки прописей норовили уйти за 10 мегабайт из-за сотен картинок (в т. ч. самих прописей). А самый злобный учебник, подготовленный по стандартам ABBEE, тянул на 156 Мб.
Простой чат таких не ест. Даже по одному. Проект ест, но не больше десяти, а каждый кусочек чтоб не больше десяти Мб.
Две недели мы каторжно плясали с бубнами, сначала сжимая пдфы (в Акробате, а потом вообще вручную, уменьшая каждую страницу), а после пытаясь скормить полученное младенцу. Тот плевался, зависал и требовал поделить файлы на всё более мелкие кусочки.
А попутно еще ругался, что не понимает гадких прописей! Что там везде буква а! Аааааааааааа!
В конце концов мы поделили наши 18 изданий на две группы: книжки отдельно, тетрадки отдельно.
Потом вручную набрали образцов прописей из тетрадок и предложили гугнивцу.
И что вы думаете? Тут же всё слопал, прочитал и выдал вполне разумный анализ содержания прописей по смыслу текстов, социальному составу учеников, по нагнетанию политики в учебный процесс.
Тогда мы нарезали книжки дольками, сократили число до 10 и размер до 10 Мб, стали загружать… Опять не жрёт.
Тут Юля не выдержала и спросила: тебе чего надо? И чат вдруг выдал секрет: оказывается, в тайном правиле загрузки общий объем файлов не должен быть больше 80 Мб! То есть 10 по 10 равно 80. Славно.
Уменьшили. Отбросили все лишние копыта. Съел.
Финальный пдф прилагаю. Ссылка в комменте. Сами смотрите, насколько глубоко чат разобрался в обучении письму в период от 1915 до 1961 года. Мне кажется, хорошо поработал — и рассказал совершенно не так, как я )
На всё исследование ушло минут пятнадцать.
Единственное, чего чатик так и не понял — чем писали. Это несложно объяснить, но мне, честно говоря, немного надоело с ним возиться )
Снимки
Как это выглядело в канале